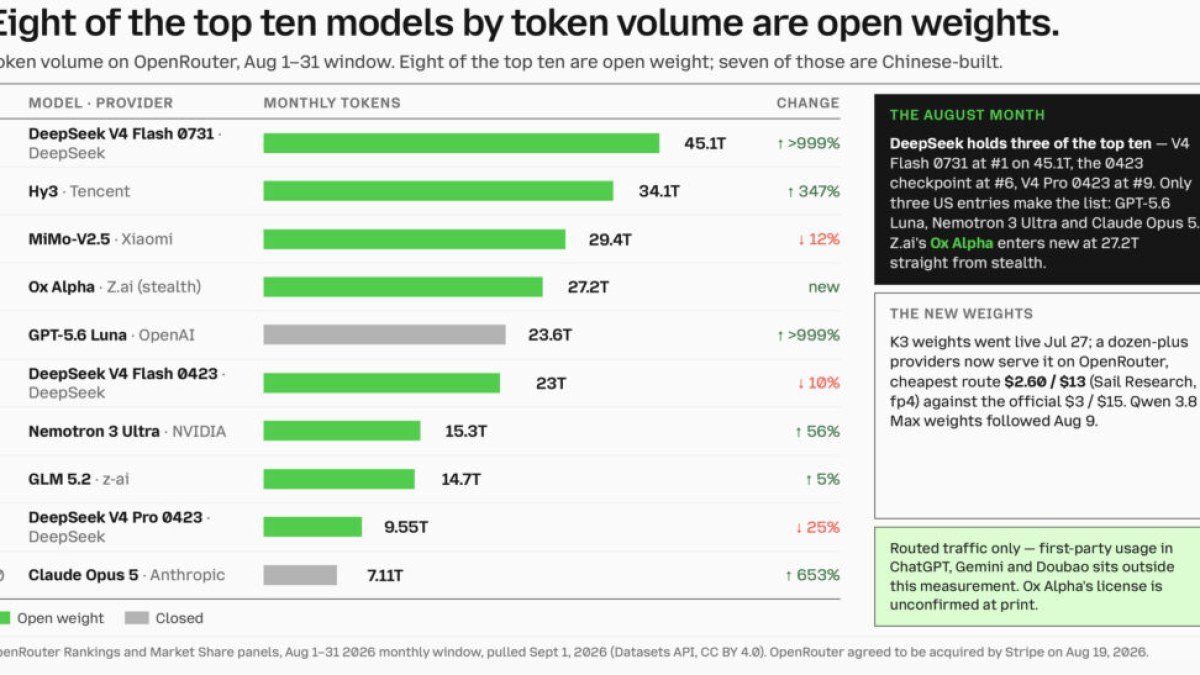
Quatre mois et demi. C’est le délai qui sépare aujourd’hui les meilleurs modèles d’intelligence artificielle en accès libre des systèmes propriétaires les plus avancés, selon le rapport State of Open Source AI publié par Mozilla le 14 septembre 2026. Un chiffre précis, presque chirurgical, qui cristallise une course technologique dont l’issue déterminera qui contrôle réellement l’IA de demain : une poignée de géants fermés, ou une communauté ouverte capable de les concurrencer.
Ce que mesure concrètement ce retard de 4,4 mois
Avant d’interpréter ce chiffre, il faut comprendre comment Mozilla le calcule. Le rapport compare les performances des meilleurs modèles open source disponibles à celles des modèles fermés de référence sur des benchmarks standardisés, puis estime le décalage temporel entre les deux courbes de progression. En d’autres termes : un modèle ouvert publié aujourd’hui atteint des capacités équivalentes à celles qu’un système propriétaire affichait il y a environ quatre mois et demi.
Ce n’est pas une mesure de l’infériorité absolue de l’open source, mais bien de la vitesse relative des deux camps. Et c’est précisément là que réside l’information la plus intéressante : il y a encore deux ans, certains analystes parlaient d’un retard de douze à dix-huit mois. Le fossé se comble, même si la frontière des modèles fermés continue elle aussi de progresser rapidement.
Pourquoi les modèles propriétaires conservent cette longueur d’avance
La réponse tient d’abord aux ressources. OpenAI, Google DeepMind, Anthropic ou Meta investissent des milliards de dollars dans des infrastructures de calcul que la communauté open source ne peut pas répliquer à l’identique. Entraîner un modèle de pointe sur des milliers de puces spécialisées pendant plusieurs mois représente un coût que seuls ces acteurs peuvent absorber de manière continue.
Il y a aussi une question de données. Les grands laboratoires disposent souvent d’accords exclusifs avec des producteurs de contenu, de capacités de filtrage et de nettoyage des données à grande échelle, et d’équipes entières dédiées à l’alignement des modèles. La communauté ouverte compense par l’ingéniosité architecturale et la vitesse d’itération collective, mais elle part rarement avec les mêmes matières premières.
« Le retard de 4,4 mois n’est pas une sentence : c’est un indicateur de dynamique. Ce qui compte, c’est la trajectoire, pas seulement la position actuelle. » Rapport Mozilla, State of Open Source AI, septembre 2026.
Les arguments contradictoires : retard réel ou illusion de mesure ?
Certains chercheurs nuancent fortement la portée de ce chiffre. D’un côté, les partisans de l’open source font valoir que les benchmarks utilisés favorisent des tâches très spécifiques où les modèles propriétaires ont été explicitement optimisés. Sur des usages concrets comme le code, la synthèse de documents ou la génération de textes spécialisés, des modèles ouverts comme LLaMA ou Mistral s’avèrent souvent comparables en pratique, voire supérieurs dans certains contextes.
De l’autre côté, les défenseurs des systèmes fermés soulignent que la frontière technologique n’est pas seulement une affaire de performance brute : la sécurité, la modération, la résistance aux usages malveillants sont des dimensions où un modèle totalement ouvert présente des vulnérabilités structurelles. Un modèle en accès libre peut être modifié, ses garde-fous supprimés, ses sorties détournées à des fins que ses créateurs n’avaient pas anticipées. Ce n’est pas un argument contre l’open source en soi, mais une limite réelle que le rapport Mozilla lui-même ne masque pas.
Il faut aussi questionner ce que signifie « modèle ouvert » en 2026. Certains acteurs publient leurs poids de modèle tout en gardant leurs données d’entraînement secrètes, ou imposent des licences d’utilisation commerciale restrictives. L’open source de l’IA ressemble parfois plus à un marketing qu’à une philosophie cohérente, et le rapport de Mozilla prend soin de distinguer les degrés d’ouverture réelle.
Ce que ce rapport change pour les utilisateurs et les entreprises
À retenir
- Écart mesuré : les modèles open source accusent un retard de 4,4 mois sur les modèles fermés des grands laboratoires, selon Mozilla.
- Source officielle : le rapport State of Open Source AI, publié le 14 septembre 2026, constitue la référence la plus récente sur ce sujet.
- Enjeu central : la vitesse à laquelle cet écart se réduit conditionne l’équilibre de pouvoir entre communauté ouverte et acteurs propriétaires.
Ce rapport de Mozilla arrive à point nommé pour rappeler que la question n’est pas de savoir si l’open source rattrapera les géants, mais à quelle vitesse et dans quelles conditions. Quatre mois et demi, c’est une éternité dans le rythme effréné de l’IA actuelle, mais c’est aussi infiniment plus gérable que ce que l’on craignait il y a encore deux ans. La course reste ouverte, et c’est peut-être la meilleure nouvelle de ce rapport.
En savoir plus sur Glorieux Geek
Subscribe to get the latest posts sent to your email.